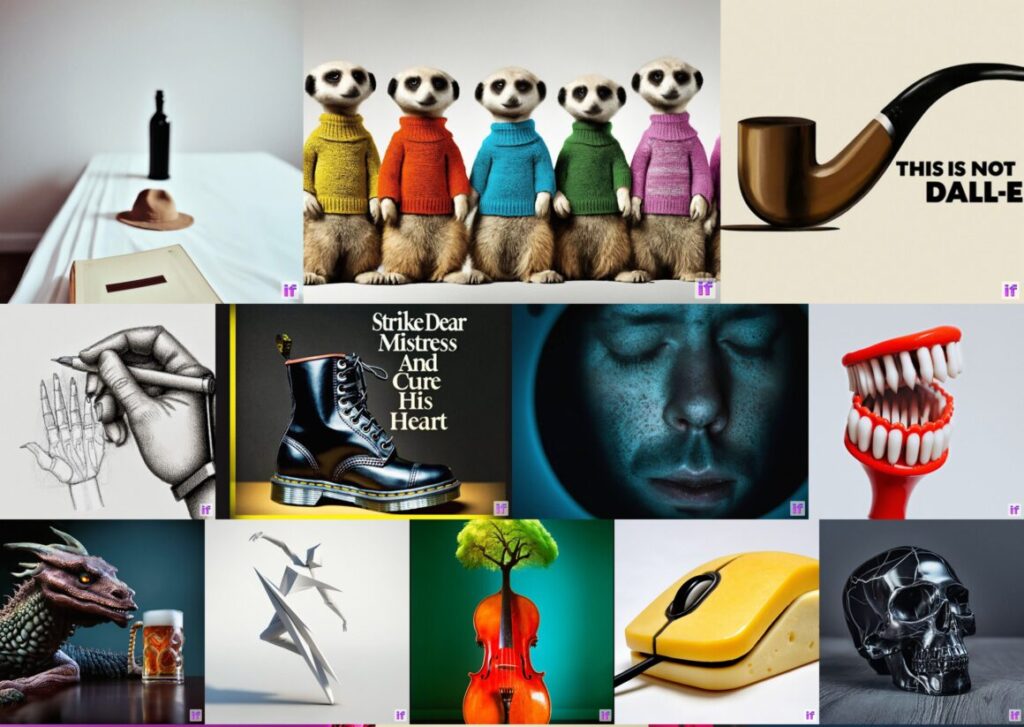
Das DeepFloyd Lab bei StabilityAI hat DeepFloyd IF vorgestellt, ein quelloffenes Text-zu-Bild-Modell, das fotorealistische Bilder auf der Grundlage von Textaufforderungen erzeugt. Das Modell besteht aus einem Encoder für eingefrorenen Text und drei kaskadierten Pixeldiffusionsmodulen, die Bilder mit steigender Auflösung erzeugen. Das Modell verwendet einen auf dem T5-Transformator basierenden Encoder für eingefrorenen Text, um Texteinbettungen zu extrahieren, die dann in eine UNet-Architektur eingespeist werden, die mit Cross-Attention und Attention Pooling verbessert wurde. Das Modell übertrifft die aktuellen State-of-the-Art-Modelle und erreicht einen Zero-Shot-FID-Wert von 6,66 auf dem COCO-Datensatz. Das Modell ist hocheffizient und benötigt mindestens 16 GB vRAM zur Nutzung. Das Modell kann in den Modi Dream, Style Transfer, Super Resolution und Inpainting verwendet werden. Das Modell ist in die Hugging Face Diffusers-Bibliothek integriert, die es den Benutzern ermöglicht, den Bilderzeugungsprozess anzupassen und Zwischenergebnisse einfach zu überprüfen. Die in dieser Codebasis verfügbaren Modelle haben bekannte Einschränkungen und Verzerrungen, und der Code wird unter einer maßgeschneiderten Lizenz veröffentlicht. Die Schöpfer von DeepFloyd IF sind Alex Shonenkov, Misha Konstantinov, Daria Bakshandaeva, Christoph Schuhmann, Ksenia Ivanova und Nadiia Klokova. Das Modell wurde mit unschätzbarer Unterstützung von StabilityAI und seinem CEO Emad Mostaque, LAION und Huggingface-Teams trainiert.